sourceurl: "https://mp.weixin.qq.com/s/ty1RWtrqrlIxveQ0X1eCOQ" title: "从Claude-Code来看Loop和Goal的区别" account: "架构师" publishedat: "2026-08-29 23:44:15" savedat: "2026-08-31 10:46:16" syncid: "art31080e696476426b914f7215dfdf82c1" parsestatus: "ok"
# 从Claude-Code来看Loop和Goal的区别
架构师(JiaGouX)
我们都是架构师! 架构未来,你来不来?
做过几年研发以后,会发现团队里其实有大量工作,不难,但特别闹腾。
内部 SDK 已经升到 v2,十几个服务里还有几个偷偷跑着 v1;某个 Feature Flag 半年前就全量了,代码里的分支和废弃配置一直没人敢删。
日常研发里,依赖扫描每周都在报高危漏洞。升级一个版本到底会不会影响业务,要有人翻代码、看 changelog、跑测试;某个定时任务偶尔失败,日志里像网络抖动,也可能是上游接口已经改了行为。
这些事以前大多靠人。它们都需要人为判断,还横跨代码、Git、CI、发布平台、日志、监控和团队协作。仅仅靠自动化脚本很难提前把所有情况写死。
这类工作,反而是 Agent 擅长的。
比如每周五晚上,让 Agent 把几个核心仓库扫一遍:找到旧 SDK 的调用点,判断升级影响,修改代码,跑单测和集成测试;风险低的开一个 PR,风险高的留下原因和建议,等负责人决定。
看起来很不错。但是,麻烦往往出在下一次回来时。环境已经变了。
有个仓库的 CI 跑了四十分钟才变红,Agent 得判断是自己改错了,还是测试环境 Redis 又挂了。一个 PR 到周一才等到负责人 Review,中间主干已经合了三次代码,上周验证的那份代码,已经不是当前主干了。
甚至“创建一个 PR”这种小事也不简单。
Agent 调 GitHub API,等了三十秒,收到一个 504。它该不该再调用一次?不一定。第一次请求可能没成功,也可能 PR 已经创建,只是响应没有回来。直接重试,第二天仓库里可能出现两个一模一样的 PR。
绕了一圈,还是回到几件老生常谈的问题:
状态、重试、幂等、权限、并发修改、任务调度、失败恢复和最终验收。
前几天聊 Agent Loop 和 Harness 时,反复碰到两个问题:任务怎么接着跑,什么条件下才算真的做完。
今天周末,重新翻了翻 Claude Code 代码里的 /loop ,又对照了官方文档里的 /goal 。放在一起看,实际上没有那么复杂。一个安排下一次什么时候做,一个定义做到什么程度才算结束。
之前做 Agent 开发时经常在想,随着大模型越来越牛逼,Harness 应该会越来越薄。甚至不少 skills、tools 都可能被模型能力覆盖掉。
模型越来越会做事以后,Agent 系统究竟应该删掉什么,又必须留下什么?
如果真往这条路走,过去写死在 Harness 里的“怎么做”会慢慢减少。看到 CI 失败,模型可以先看日志还是 diff;发现接口报错,也可以自己决定要不要查最近发布。SDK 迁移不必再把每一步都提前写死。
但仓库范围、分支和提交、PR 编号、CI 回执、生产版本、回滚结果、权限和负责人批准,都不能靠模型“觉得”。它们必须是系统里的事实。
这里有个地方很容易混。5 月拆 Codex /goal 时,看到的是一套偏重的做法:目标进入 thread 和 state-db,运行时记录 active、paused、complete、budget_limited,也管预算耗尽后的收束。Claude Code 现在的 /goal 轻得多,它在当前会话里加一个独立评估器,每轮结束时判断目标是否满足。
名字一样,收进去的职责并不一样。Codex 更像在运行时里保存一张长期任务卡;Claude Code 先把“该不该停”这件事从主模型手里分出来。两种做法碰到的是同一个问题:模型说“差不多了”,不能直接当作任务完成。
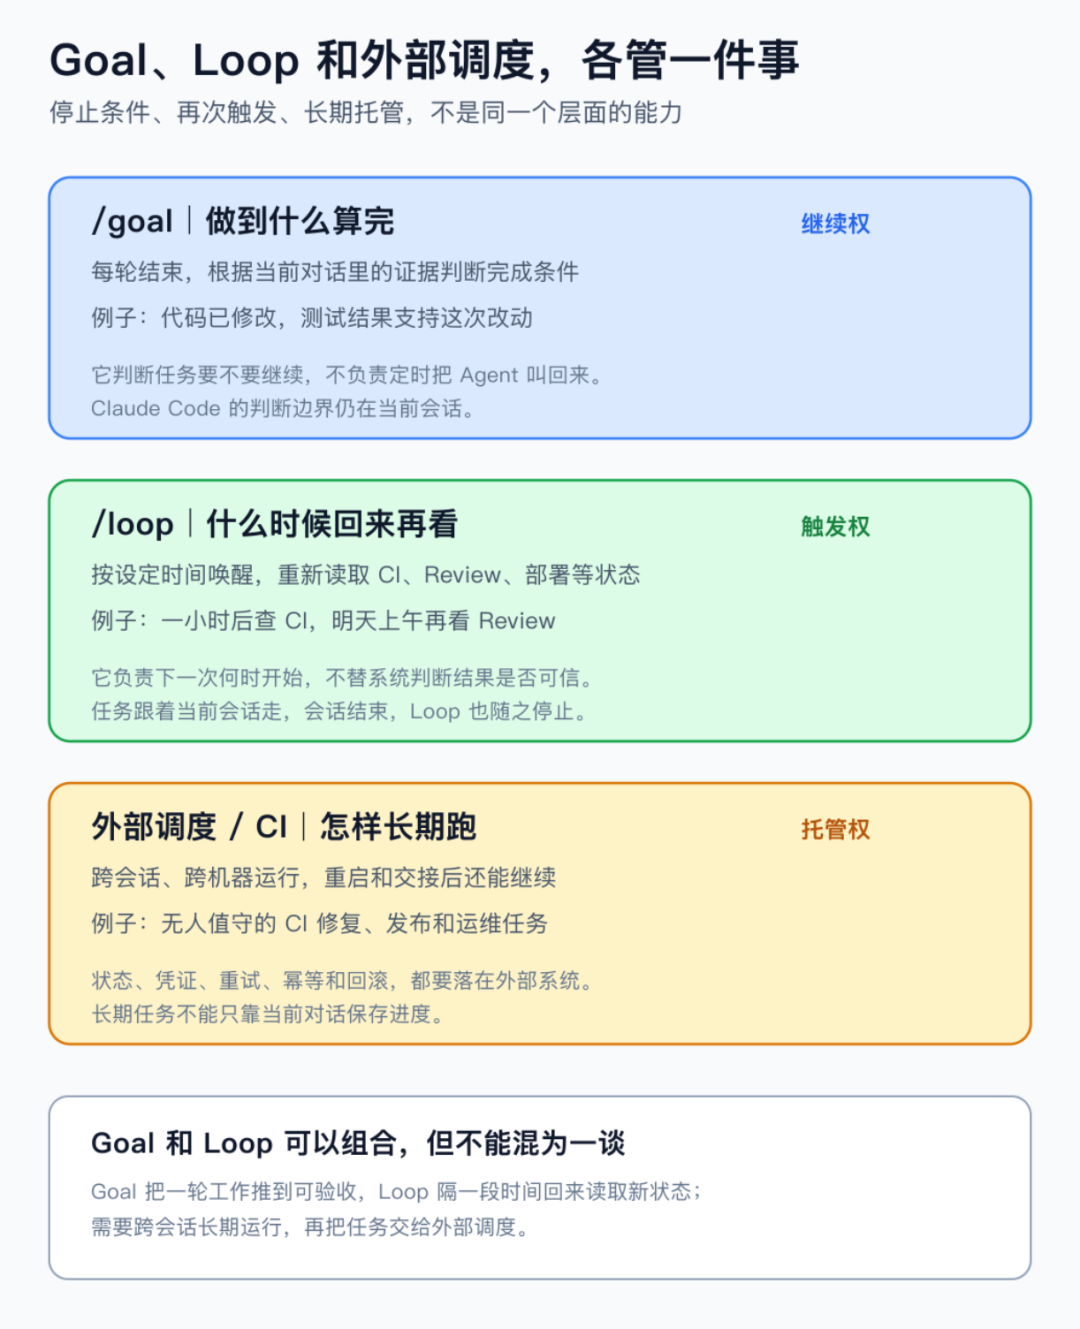
简单说, /goal 管“做到什么算完”, /loop 管“什么时候回来再看”。
/goal 更像一张写清楚验收条件的任务卡。每轮结束,会用当前对话里已经出现的证据核对;证据不够,任务就不会被判定为完成。它不会替模型执行命令,也不会替系统做权限控制。比如“测试通过”,得有命令输出或远端构建回执,不能只凭一句判断。
前面聊 Claude Code 四类 Loop 时,把这两个动作分别叫作继续权和触发权。这个分法比命令名更容易落到工作里:有明确终点、可以连续推进的 SDK 迁移,交出去的是继续权;需要等 CI、Review、部署或监控发生变化,交出去的是下一次触发。两者也可以串起来: /goal 把一轮改动推到可验收, /loop 隔一段时间重新读取外部状态。
Loop、Goal 与外部调度的区别比如 PR 已经开了,CI 还没结束,那就一小时后再看;CI 通过但没人 Review,第二天上午再看;负责人提了意见,下一轮继续改;代码合并了但还没部署,继续等部署;上线后观察错误率、延迟和日志,达到验收条件再结束。
做这种任务,节奏更像日常维护:先处理一部分,等外部状态变化,再回来核对事实,继续推进,最后验收。
这里也正好能接上前面说过的“反馈契约”。落到这条 PR 链路里,就是每次回来都要重新拿到当前 commit、CI 结果和 Review 意见,动作完成后还要留下新的测试或远端回执;连续几轮没有新证据,或者碰到发布冻结、权限和数据迁移,就该停下来交回给人。 /loop 负责叫醒,反馈契约决定这一轮有没有依据继续。
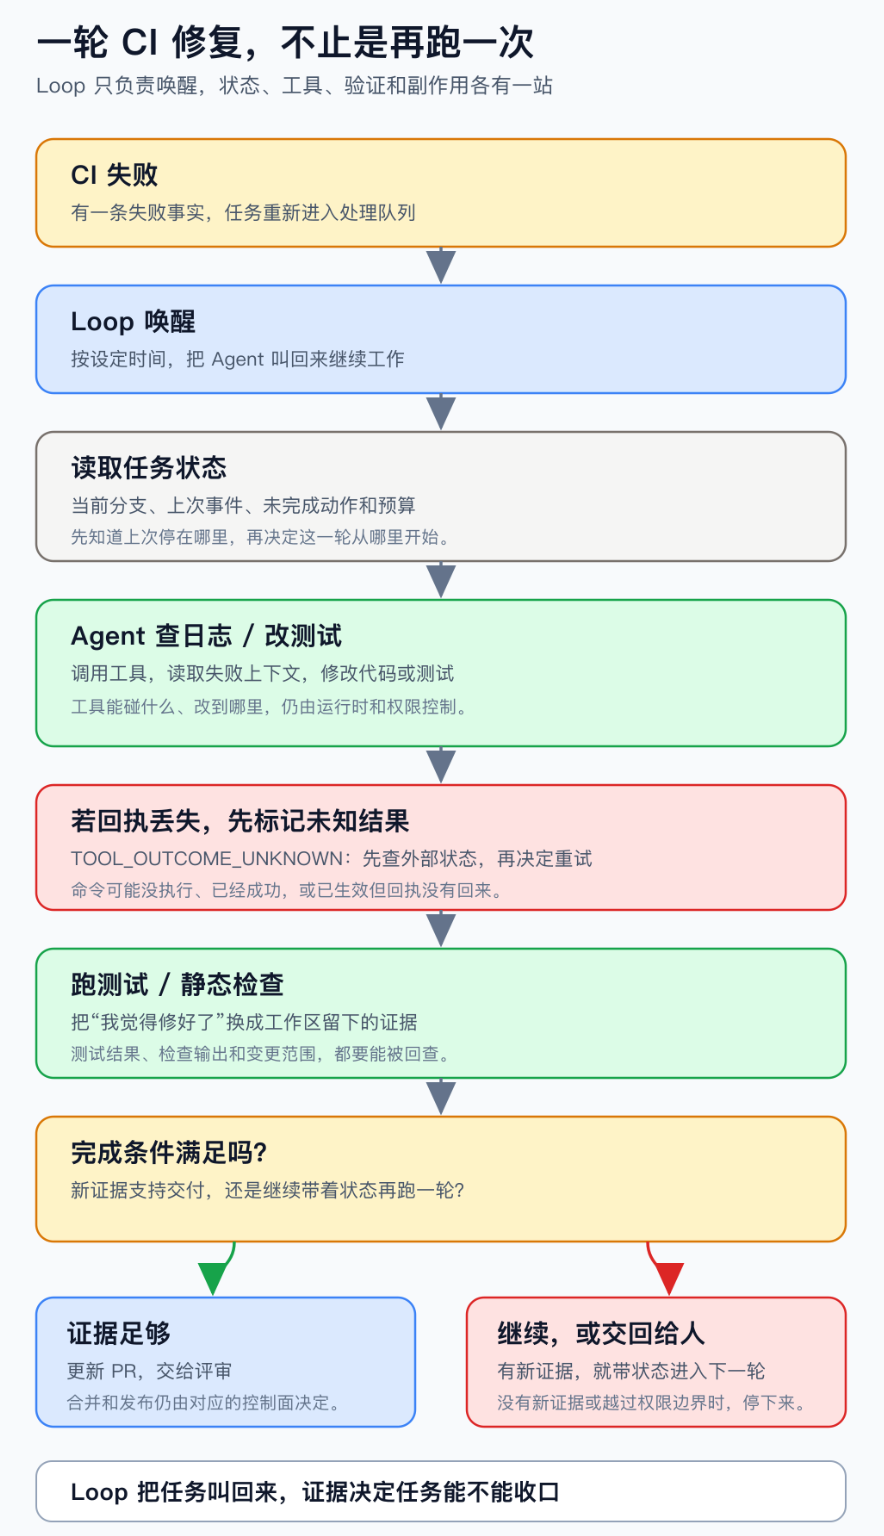
一轮 CI 修复如何接着跑Loop 解决了“什么时候再来”,却没有自动解决“上次到底发生了什么”。Agent 可以自己决定下一步做什么,系统仍要保存每一步可核对的结果。
# /loop 不是一条 while true
先看命令本身。在 2.1.88 里, /loop 的用法长这样。
/loop [interval] <prompt>不写间隔时默认 10m ,最小粒度是 1 分钟,支持 s 、 m 、 h 、 d 。它既能解析开头的 5m ,也能识别结尾的 every 20m 、 every 5 minutes 。解析完成后,代码把间隔转换成标准五字段 cron,再调用 CronCreate 创建循环任务。
任务创建后,解析出来的 Prompt 会马上执行一次,不会等到第一次 cron 时间才开始。 /loop 30m check the deploy 的含义是“现在先检查一次,以后按 30 分钟的节奏再检查”。
如果输入只有 /loop 5m ,Prompt 为空,命令只显示用法,不会创建任务。也就是说,字符串要先经过解析和边界判断,才会交给调度器。
间隔也不是任意数字都能原样表达。秒会向上取整到分钟;超过 59 分钟的分钟数要换算成小时,而且必须能被 24 小时整除;不整齐的间隔要选择接近的可表达值,并告诉用户发生了取整。调度器使用本地时区,不需要额外做时区转换。
自己写一个 while (true) { sleep(); run(); } 只有重复动作。 /loop 还定义了输入语义、调度表达式、任务 ID 和取消入口。
它也不是无条件可用的命令。注册时要经过构建期的 AGENTTRIGGERS ,运行时还要通过 tengukairoscron 开关;本地设置 CLAUDECODEDISABLECRON 可以直接关掉整套调度。已有任务在运行过程中也会轮询这个开关,关闭后下一次检查就停止触发。
# Loop 的核心是调度器
CronCreate 的任务有两种生命周期。
durable: false:任务只放在当前 Claude 进程的内存里,进程退出就消失。durable: true:任务写入项目目录下的.claude/scheduled_tasks.json,重启后由调度器重新加载。
代码里的持久化开关默认打开,但这不等于每个任务都会落盘。调度工具的说明把两种情况分开了:临时提醒和“过一小时再看”通常使用 session-only;只有用户明确要求每天执行、长期执行,才使用 durable。能力开关和任务默认值是两件事,混在一起就会误判产品行为。
调度器本身每秒检查一次任务,并监听 scheduled_tasks.json 的变化。它用按目录加锁的方式避免两个 Claude 进程重复触发同一个任务。任务触发后,循环任务会从当前时间重新计算下一次执行时间;如果进程一度忙住,不会把积压的每一轮瞬间补跑。
代码还处理了两个容易踩坑的地方:
- 循环任务会加入确定性的抖动(jitter),默认最多晚一个周期的 10%,上限 15 分钟,避免所有客户端同时撞在整点。
- 循环任务默认创建 7 天后自动过期,最后触发一次再删除;标记为
permanent的任务才不受这个限制。
一次性任务的处理又不同。durable 的一次性任务如果在 Claude 关闭期间错过,启动时会被识别为 missed ,交给上层决定是现在补做还是丢弃;循环任务不会按错过的次数逐个追赶,而是按当前时间重新排下一次。
在 REPL 里,触发的 Prompt 也不会直接打断正在进行的查询。 useScheduledTasks.ts 把它放进命令队列,优先级是 later ,等当前轮次结束后再执行,并用 WORKLOAD_CRON 标记这类流量。调度发生了,不代表模型立刻抢占用户正在看的工作。
所以, /loop 更像一个带生命周期、持久化和并发边界的调度入口,还不是完整的工作流平台。真正的工作状态,还得另找地方保存。
# 会话能保存任务,不等于能保存事实
回到前面的 SDK 兼容性巡检。Agent 第一次运行时,扫描 services/ 和 jobs/ ,找到旧调用,能自动迁移的就改代码、跑测试、开草稿 PR;涉及公共协议和数据迁移的,只生成报告。
下一次 /loop 触发时,模型要先核对几组事实。
- 1. 上次扫描对应哪个提交?哪些调用点已经处理?
- 2. 草稿 PR 是否真的创建?远端构建是通过、失败,还是仍在排队?
- 3. 负责人的意见有没有回来?上一条频道消息究竟发出没有?
仅靠对话上下文回答不了这些问题。上下文会压缩,工具输出会截断,进程会重启,网络调用还可能出现“服务端已执行、客户端没拿到回执”的未知结果。
把状态分成三层,更容易看清问题。
- 模型上下文 :本轮推理需要的文件片段、命令输出摘要和下一步线索;
- Harness 运行记录 :工具调用、参数、开始和结束时间、超时、中断、重试,以及当前执行位置;
- 外部事实 :Git 提交、PR 状态、构建回执、频道消息、审批记录和业务数据库里的最终结果。
“完成”也要拆开看:进程结束、Agent 认为目标满足、测试或日志支持这个结论、改动通过权限和发布检查。四层不一定同时发生。一次 /goal 结束,最多说明会话和评估器已经停下来;远端 CI、审批和上线后的监控,仍要回到外部系统核对。
比如发消息超时,运行记录可以写成 TOOLOUTCOMEUNKNOWN ,下一轮先按幂等键查询消息服务,再决定是否重试。创建 PR 返回未知,就按分支和提交 SHA 查询代码托管平台。Agent 负责根据证据继续工作,系统负责提供能拍板的记录。
这和网银页面转圈时先查流水是同一个道理:不确定时不要凭感觉再点一次。
# 模型变强以后,Harness 退到哪里
Boris Cherny 在公开访谈里讲过一种做法:模型升级时,先把系统提示和工具提示整体删掉,再一条条加回去,看哪些内容真的改变结果。访谈标题里的“删掉 80% Prompt”,更适合被理解为持续消融,而不是永久比例。
放到内部 Agent 里,做法也类似。早期模型不会规划,Harness 里会写“先搜目录,再开文件,再跑命令”的手把手流程。模型变强后,这些步骤可能只是在占上下文、限制选择。重复教模型做决定的文字可以删,约束真实副作用的边界要留下:仓库范围、分支保护、凭证权限、工作区隔离、人工审批、回滚入口和审计记录。
落到实际系统里,大致是三层分工:
模型理解代码和迁移指南,选择工具,遇到业务语义不清时停下来。
Harness 管一次运行:装载上下文,调用工具,处理超时和中断,把事件写下来,并把下一轮放回正确的队列。它可以少一些固定流程,但不能少掉恢复所需的记录。
调度器和业务系统管时间与事实:Cron 何时触发、任务是否过期、哪个进程持有锁、PR 是否真的创建、测试是否在远端完成、谁批准了合并。 -p 模式的 Agent 子进程不会自己运行调度器;SDK 类型层虽然预留了 watchScheduledTasks() ,但在 2.1.88 源码里仍是未实现的接口。要做无人值守服务,需要由外部守护进程或平台持有调度职责,不能误以为启动一个子进程就获得了长期任务能力。
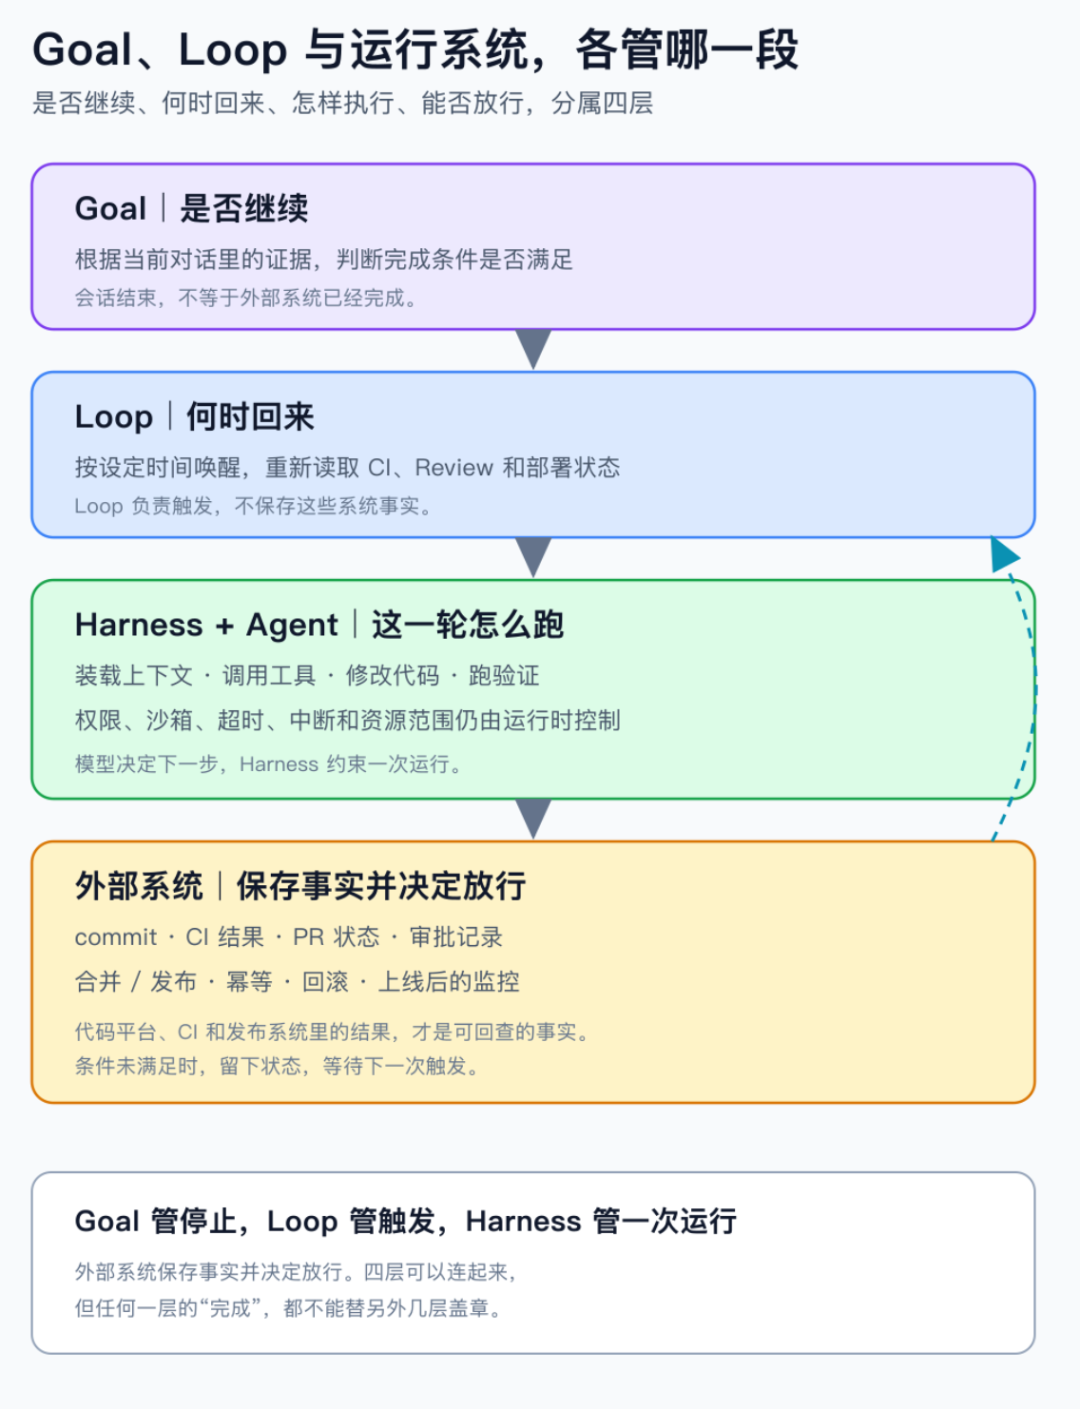
Loop、Harness 与业务系统的边界“Harness 变薄”不是把运行时删到只剩一个 Prompt。顺利路径上,Harness 少替模型安排步骤;异常路径上,边界和记录仍要写清。
# 什么时候适合用 Loop
适合 /loop 的任务,通常有稳定输入、明确频率和可检查结果:依赖版本巡检、死代码扫描、文档链接检查、测试覆盖率缺口整理。每一轮结束,都能留下提交、报告或待确认清单,下一轮可以从这些记录继续。
如果验收标准本身还在讨论,比如“把架构做得更优雅”“让界面更有质感”,定时触发只会重复制造意见。即便代码和测试都通过了,如果下周正好是大促,按团队发布规则也应该先停下来;生产写入、权限变更、资金操作和不可逆数据迁移,也不适合直接交给循环自动放行。
真要在团队里试,可以先挑一小组真实任务做基线。那些只是在纠正旧模型习惯的 Prompt,可以删掉;范围、停止条件和证据要求,要写进任务定义;接入 PR、构建、消息和审批状态,则放到后面。每一步都能回看,才知道删掉的是噪音,还是某道必要的保护。
Agent 进入生产以后,Loop 不只是“多跑几次”。它把时间触发接到一次运行,再把一次运行接到外部事实;模型可以越来越自主,系统仍要知道谁授权、发生了什么、下一步从哪里继续。
# 参考资料
- 1. Boris Cherny:We Cut 80% of Claude Code’s Prompt|Y Combinator
- 2. Boris Cherny:Building Claude Code|Y Combinator Library
- 3. Anthropic’s Boris Cherny:Why Coding Is Solved, and What Comes Next|Sequoia Capital
- 4. Keep Claude working toward a goal|Claude Code 官方文档
- 5. Run prompts on a schedule|Claude Code 官方文档
- 6. Follow a goal|OpenAI Codex 官方文档
- 7. Codex
goals.rs源码|GitHub - 8. Loop Engineering|Addy Osmani
- 9. Practical Loop Engineering|Addy Osmani
- 10. Long-running Agents|Addy Osmani
如喜欢本文,请点击右上角,把文章分享到朋友圈
如有想了解学习的技术点,请留言给若飞安排分享
因公众号更改推送规则,请点“在看”并加“星标”第一时间获取精彩技术分享
·END·
相关阅读:
Loop Engineering,应该赞成还是反对?

Claude 做方案,Codex 写代码:多模型协作怎么交接才稳

架构排熵:Loop Engineering 的持续清理系统

Claude Code 27 条实用技巧,快速升级

我终于搞明白了:Claude Code 为什么会忽略指令了

Loop 工程实战:从任务循环到可维护闭环

CLAUDE.md 拆解:Agent 进仓库前的上下文入口

Claude、Codex、Mira 都在讲 Loop,架构师更该看什么

如何用 Claude Code 搭建自己的 AI 学习系统

Anthropic CEO 核心访谈:AI时代,企业、职场与治理

Loop详解:从ReAct到Loop Engineering,Agent到底在循环什么

Harness工程还没唱罢,Environment工程已然登场

设计Self-Harness架构:会自我改进的Harness

Fable 5 的信号:Agent 开始拼 Runtime

Anthropic工程师:我们日常如何使用Claude Code
版权申明:内容来源网络,仅供学习研究,版权归原创者所有。如有侵权烦请告知,我们会立即删除并表示歉意。谢谢!
架构师
我们都是架构师!
关注架构师(JiaGouX),添加“星标”
获取每天技术干货,一起成为牛逼架构师
技术群请加若飞:1321113940 进架构师群
投稿、合作、版权等邮箱:admin@137x.com
原文链接:https://mp.weixin.qq.com/s/ty1RWtrqrlIxveQ0X1eCOQ